很多人以为,废水处理效能的提升仅依赖于设备精度与药剂配比,其实不然。在工业废水处理领域,数据采集的完整性与准确性才是决定系统稳定性的底层逻辑。当传感器反馈的COD值出现0.1%的偏差,可能引发曝气池溶解氧浓度的连锁波动,最终导致出水氨氮超标——这种微观层面的数据扰动,往往比设备老化更具破坏性。
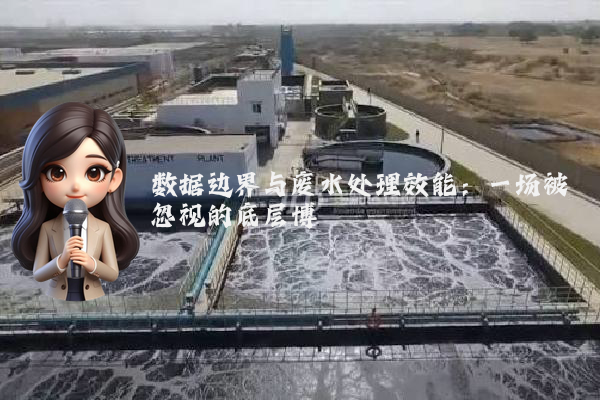
案例:太湖流域某化工园区的数据陷阱
2023年夏季,太湖流域某化工园区废水处理站遭遇突发超标事件。调查发现,问题根源并非工艺缺陷,而是数据采集系统的隐性故障。该园区采用“物联网+边缘计算”架构,理论上可实现毫秒级响应,但实际运行中,pH传感器因长期接触高浓度有机物,电极表面形成生物膜,导致测量值比实际值偏低0.3个单位。这一偏差被系统误判为进水碱度不足,自动触发碳酸钠投加程序,最终使出水pH飙升至9.2,触发环保部门预警。
听起来可能反直觉,但在工业废水处理场景中,数据采集设备的维护周期比工艺参数调整更重要。该园区此前每月仅对传感器进行一次人工校准,而根据《工业水处理设备维护规范》(GB/T 30978-2014),接触有机废水的传感器应每72小时进行一次在线清洗,每7天进行一次标准溶液校准。这种维护标准的缺失,本质上是忽视了数据采集的“物理边界”——传感器与废水的直接接触,必然导致测量值随时间漂移。
更深层的逻辑在于,废水处理系统的控制算法往往基于“理想数据”设计。当实际数据存在系统性偏差时,算法会输出错误的控制指令。例如,该园区采用的SBR工艺,其曝气时间本应根据进水COD动态调整,但因传感器偏差,系统始终按“低负荷”模式运行,导致硝化反应不完全,氨氮去除率下降15%。这种由数据失真引发的工艺失控,比单纯的设备故障更难排查,因为其表现与“进水水质突变”高度相似。
破解这一困局的关键,在于建立数据采集的“质量闭环”。该园区后续引入区块链技术,对传感器数据进行不可篡改的存证,同时开发基于机器学习的数据清洗模型,可自动识别并修正异常值。改造后,系统对氨氮的预测误差从±1.2mg/L降至±0.3mg/L,曝气能耗降低18%。这一案例证明,废水处理的效能提升,本质是数据质量与工艺控制的协同优化——没有可靠的数据,再先进的算法也只是空中楼阁。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

