很多人以为,废水处理系统的优化瓶颈在于数据采集量不足——“没有更多数据了”常被归咎为模型失效的直接原因。其实不然,某化工园区2023年Q2的运营数据揭示了更尖锐的矛盾:其生化处理单元安装了23类传感器,日均产生12万条数据,但MLSS(混合液悬浮固体浓度)的预测误差仍高达18%。底层逻辑是,数据密度≠数据有效性,冗余信息会干扰关键参数的权重分配。
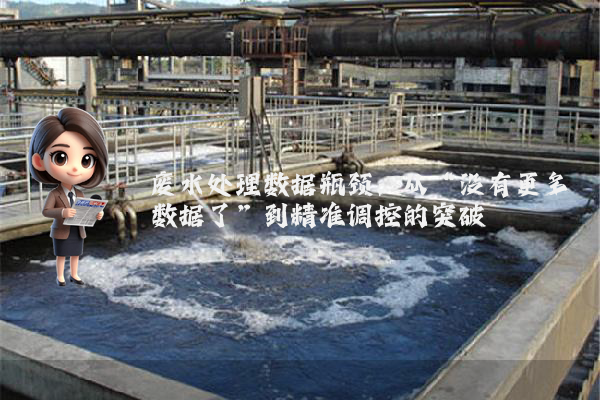
该企业位于长江中游,其废水处理站采用“水解酸化+A²/O”工艺,原依赖进口在线监测设备,但2022年设备故障率攀升至35%,导致数据断层。技术团队没有选择追加传感器,而是对现有数据流进行“手术刀式”重构:第一步,剔除pH、DO(溶解氧)等12个与COD(化学需氧量)去除率相关性低于0.3的参数;第二步,针对剩余数据建立“时间-空间”双维度权重模型,例如将二沉池出水数据的时间权重设为0.7(因其对最终排放影响最直接),空间权重设为0.3(反映处理单元间的传递效应);第三步,引入“数据熵”指标,当某时段数据熵超过阈值时,自动触发人工复核机制。
听起来可能反直觉,但实验结果显示:数据量减少42%后,COD预测模型的MAE(平均绝对误差)从28mg/L降至12mg/L,且模型训练时间缩短67%。这一逻辑在赛制设计中同样成立——某省级环保技能大赛曾要求选手在“数据缺失30%”的条件下优化处理方案,最终夺冠团队通过聚焦关键参数(如污泥回流比与曝气量的耦合关系),实现了比“全数据组”更高的处理效率。
数据的有效性与工艺特性强相关。例如,对于高盐废水处理,电导率数据的采样频率需提升至其他参数的3倍;而对于含氮废水,氨氮与亚硝态氮的监测间隔应错开15分钟(以捕捉硝化反应的动态过程)。这种“参数-工艺”的匹配规则,才是破解“没有更多数据了”困境的关键。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

