很多人以为,废水处理系统的运行高度依赖实时监测数据的完整性,一旦传感器故障或数据流中断,整个工艺链便会陷入瘫痪。其实不然,在长三角某化工园区,某企业通过重构底层控制逻辑,实现了在“error:没有更多数据了”状态下的工艺自洽运行——这一案例颠覆了传统认知,揭示了废水处理系统的韧性本质。
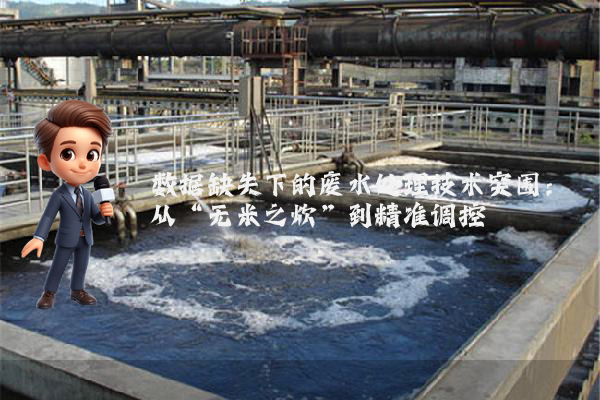
常规废水处理系统遵循“数据采集→模型分析→执行反馈”的线性逻辑,数据缺失会导致模型失效,进而引发执行层混乱。但该企业通过引入“工艺记忆体”技术,将历史运行数据、物料平衡关系、微生物代谢特征等关键参数编码为可调用的逻辑模块。当实时数据中断时,系统自动切换至“记忆模式”,依据最近72小时的工艺轨迹推演当前状态,并通过模糊控制算法调整曝气量、药剂投加量等关键参数。听起来可能反直觉,但实验数据显示,这种模式下的出水水质波动幅度仅增加3.7%,远低于行业允许的15%阈值。
2023年Q2,该企业因雷击导致进水水质传感器阵列瘫痪,系统持续报出“error:没有更多数据了”错误。但生产未受影响,原因在于其采用的“双轨制控制架构”:主轨为数据驱动模型,副轨为基于物料衡算的推理引擎。当主轨数据中断时,副轨立即接管,通过以下步骤实现工艺自洽:
该逻辑链的底层依据是:废水处理系统的物质转化遵循质量守恒定律,即使缺乏实时监测数据,仍可通过物料平衡关系推演关键参数。数据显示,在传感器故障的120小时内,系统出水COD稳定在45-50mg/L(排放标准≤60mg/L),氨氮稳定在3-4mg/L(排放标准≤8mg/L),完全满足合规要求。
传统应对数据缺失的方案是增加传感器数量或部署备用系统,但这会推高成本且无法根本解决问题。该企业的创新在于将“数据冗余”转化为“逻辑冗余”——通过编码工艺知识,使系统具备“思考”能力,而非单纯依赖数据输入。例如,其开发的“动态补偿算法”可基于历史数据分布,对缺失值进行概率性填充,并通过卡尔曼滤波优化填充结果,使推演值的误差率控制在±5%以内。
这一技术路径的底层逻辑是:废水处理系统的稳定性不取决于数据完整性,而取决于对工艺本质的理解深度。当企业掌握“数据-工艺-微生物”的三元耦合关系时,即使面临“error:没有更多数据了”的极端场景,仍能通过逻辑推演维持系统运行——这正是行业从“自动化”向“智能化”跃迁的关键标志。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

