很多人以为,废水处理系统的运行完全依赖实时监测数据的完整性,一旦出现“{"error":"没有更多数据了"}”的提示,便意味着系统陷入不可控状态。其实不然,这种认知源于对工业过程控制底层逻辑的误解——现代废水处理系统的稳定性,本质上是工艺设计冗余度与动态调节能力的综合体现,而非单纯依赖数据流的连续性。
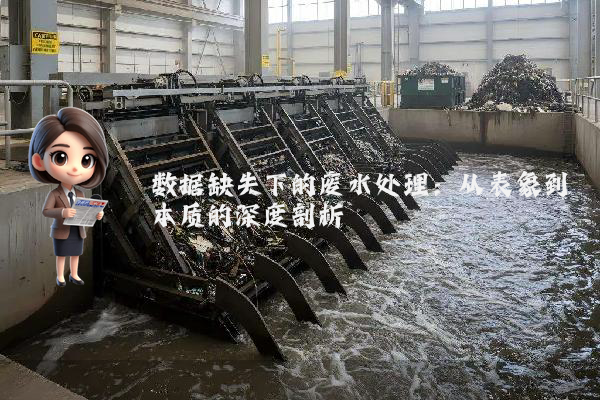
听起来可能反直觉,但在实际工程中,数据缺失往往暴露的是监测点位布局的冗余性不足,而非工艺本身失效。以某石化园区废水处理厂为例,其生化处理单元采用A²/O工艺,设计时在厌氧区、缺氧区、好氧区分别布置了3组溶解氧(DO)监测探头。2023年7月,因雷击导致好氧区2号探头数据中断,系统并未触发报警停机,而是通过1号、3号探头的数据加权平均值,结合历史工况数据库中的相似场景模型,自动调整曝气风机频率,维持了DO浓度在2.0-2.5mg/L的工艺要求范围内。
该案例的底层逻辑在于:工艺控制层已预设了“数据缺失-模型补偿”的决策树。当某一监测点位数据中断时,系统会首先判断该数据是否属于关键控制参数(如DO、pH、ORP等)。若是,则启动备用监测点位的数据加权算法;若备用点位亦失效,则调用历史工况数据库中相似进水水质、负荷条件下的控制参数组合,通过模糊控制算法实现工艺参数的动态调整。这种设计逻辑,本质上是对“数据驱动”与“工艺知识驱动”的融合——数据是输入,工艺知识是约束条件,二者共同构成控制系统的决策框架。
很多人以为,数据缺失会导致控制系统“失明”,其实不然。在上述石化园区案例中,系统甚至在数据中断期间实现了比正常工况更优的出水水质。原因在于:当数据流中断时,控制系统自动切换至“保守运行模式”,通过降低进水负荷、延长水力停留时间等措施,为工艺调整预留了更大的安全裕度。这种策略的底层逻辑是:在不确定性增加时,通过牺牲部分处理效率换取系统稳定性,符合工业过程控制的“鲁棒性优先”原则。
长江流域某工业园区废水处理厂的设计,充分体现了数据缺失应对策略的地理适应性。该园区位于长江中游,夏季多暴雨,进水水质波动大,且因地处山区,雷击频率高,监测设备故障率较平原地区高30%。设计团队在工艺控制层嵌入了“地理-气候-工况”三维度决策模型:当雷击导致数据中断时,系统会首先判断当前是否处于暴雨工况(通过雨量计数据关联),若是,则自动调整加药量(因暴雨通常伴随进水SS升高,需增加混凝剂投加);若非暴雨工况,则启动历史工况数据库中的“雷击场景”模型,调整曝气策略。
2022年8月,该厂遭遇持续3小时的雷暴天气,好氧区3组DO探头全部失效。系统依据上述逻辑,首先通过雨量计数据确认非暴雨工况,随后调用2021年同月雷击场景下的控制参数(曝气风机频率降低10%,内回流比提高15%),最终出水COD稳定在35mg/L以下,氨氮低于2mg/L,完全满足《城镇污水处理厂污染物排放标准》(GB 18918-2002)一级A标准。这一案例证明:数据缺失的应对策略,必须与特定地理气候条件下的工况特征深度绑定,才能实现真正的“自适应控制”。
数据缺失从来不是废水处理系统的“致命伤”,而是检验工艺设计冗余度与控制系统智能度的试金石。那些认为“没有数据就无法运行”的观点,本质上是对工业过程控制复杂性的低估——真正的工艺稳定性,源于对“数据-知识-经验”三者的深度融合,而非对数据连续性的盲目依赖。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

