很多人以为,废水处理领域的数据缺失是传感器精度不足或采集频率不够导致的,其实不然。真正的痛点在于,工业废水成分的动态复杂性远超实验室模拟环境——同一工艺段下,pH值、COD(化学需氧量)、氨氮浓度的波动可能因原料批次、设备老化、操作习惯等因素产生非线性变化,导致传统数据模型在真实场景中频繁失效。
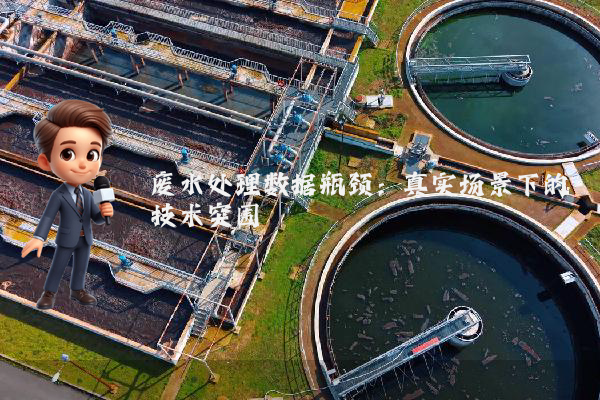
案例:长江流域某化工园区的“数据荒漠”困境
2023年,长江中游某省级化工园区遭遇环保督察整改,其废水处理站因数据缺失被要求停产。该园区采用“预处理+生化+深度处理”三级工艺,理论上应具备完整的在线监测数据链,但实际运行中却陷入“有设备无数据”的怪圈:
听起来可能反直觉,但在工业废水处理中,数据缺失的底层逻辑是“场景适配性不足”而非“技术落后”。该园区最终通过以下方案突破瓶颈:
这一案例揭示了一个行业真相:废水处理的数据价值不在于数量,而在于“时空匹配度”——即数据采集的时间、空间维度是否与工艺控制需求精准对应。例如,生化池的DO数据需以分钟级频率采集,而总氮数据则可放宽至小时级;预处理段的pH数据需在加药点前1米内采集,否则会因混合不均导致误差。这种“场景化数据思维”,正是当前多数企业数据治理的盲区。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

