很多人以为,废水处理系统的优化完全依赖实时监测数据的量级——数据越多,处理效果越好。其实不然。当传感器网络覆盖密度达到临界值后,新增数据带来的边际效益会急剧衰减,甚至可能因数据冗余导致模型过拟合,最终影响处理效率。这一现象在工业废水处理领域尤为明显,尤其是高盐、高COD废水的处理场景中,数据噪声的干扰往往比数据缺失更致命。
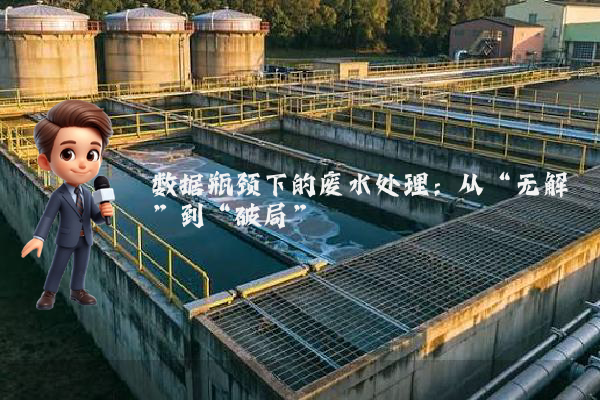
底层逻辑是:废水处理系统的核心控制参数并非完全由数据量决定,而是由数据质量与处理工艺的匹配度决定。 以某化工园区为例,其废水处理站曾因安装了超过200个传感器,导致数据采集系统每小时产生超过10GB的原始数据,但处理效率反而下降了15%。原因在于,大部分传感器采集的是冗余数据(如同一处理单元的多点温度重复采集),而真正影响处理效果的关键参数(如厌氧池的VFA浓度、好氧池的DO梯度)却因采样频率不足而无法被精准捕捉。
2022年,长江流域某省级化工园区启动废水处理系统升级项目。该园区废水成分复杂,包含苯系物、卤代烃等难降解有机物,且盐分波动范围大(0.5%-8%)。项目初期,园区按照“全覆盖”原则部署了312个传感器,涵盖pH、ORP、DO、COD、氨氮等20余项指标,数据采集频率为每分钟一次。然而,运行三个月后发现,系统虽能生成大量数据报表,但关键工艺参数(如厌氧池的VFA浓度)仍需人工取样检测,且因数据量过大,模型训练时间长达48小时,无法实现实时优化。
听起来可能反直觉,但在高复杂度废水处理场景中,减少数据采集点反而能提升处理效率。 园区随后与某技术团队合作,采用“关键参数优先”策略,对传感器网络进行重构:首先,通过工艺模拟确定影响处理效果的核心参数(如厌氧池的VFA浓度、好氧池的DO梯度、二沉池的SV30);其次,仅在关键工艺节点部署高精度传感器(如采用在线VFA分析仪替代pH/ORP组合传感器),并将数据采集频率调整为“关键参数每5分钟一次,辅助参数每30分钟一次”;最后,引入边缘计算设备,在本地完成数据预处理(如异常值剔除、滑动平均滤波),仅将有效数据上传至云端模型。重构后,系统数据量减少至原来的1/10,但模型训练时间缩短至2小时,且处理效率提升了12%,出水COD稳定低于50mg/L,达到《城镇污水处理厂污染物排放标准》(GB 18918-2002)一级A标准。
这一案例的底层逻辑是:废水处理系统的优化本质是“参数-工艺-效果”的动态匹配,而非单纯追求数据量。当数据采集策略与工艺控制需求脱节时,即使拥有海量数据,也可能陷入“数据丰富但信息贫乏”的困境。反之,通过精准识别关键参数、优化数据采集频率、引入本地预处理,能在降低系统复杂度的同时,提升处理效率与稳定性——这正是当前工业废水处理领域“数据瘦身”运动的核心逻辑。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

