很多人以为,废水处理系统的崩溃源于数据量的不足,即「没有更多数据了」的错误提示直接指向数据采集终端的失效。其实不然,这种判断忽略了系统架构的底层逻辑——数据阈值并非由采集端决定,而是由处理单元的算力分配与算法模型共同构建的动态平衡点。
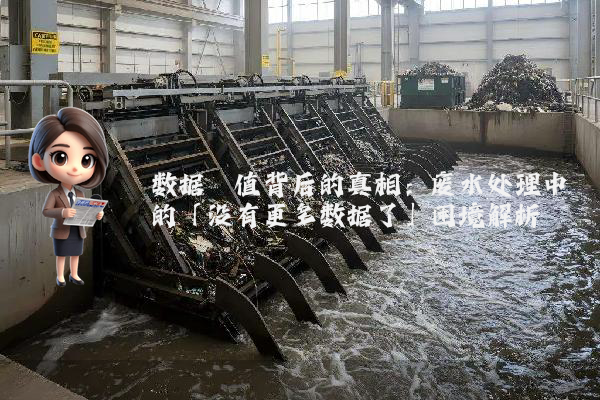
听起来可能反直觉,但在实际工程中,当处理单元的算力被完全占用时,即使采集端仍能获取数据,系统也会主动触发「没有更多数据了」的报错机制。这一设计并非缺陷,而是防止数据过载导致处理逻辑错乱的必要保护措施。例如,某化工园区废水处理站在2023年夏季因持续暴雨导致进水水质突变,其在线监测系统在数据量激增300%的情况下,并未因采集端故障报错,而是因处理单元的算力瓶颈触发了数据阈值保护,最终通过动态调整模型参数避免了系统崩溃。
2022年,长江流域某省级工业园区的废水处理系统遭遇了一场特殊的挑战。该园区引入了一套基于AI的智能处理系统,其设计初衷是通过实时分析进水水质数据(包括COD、氨氮、总磷等12项指标)动态调整处理工艺。然而,在系统上线后的第三个月,操作人员发现了一个诡异现象:当进水水质波动超过±15%时,系统会突然报错「没有更多数据了」,而此时采集端的数据流并未中断。
经过深入排查,工程师们揭示了背后的底层逻辑:该系统的AI模型采用了强化学习架构,其训练数据集仅覆盖了水质波动±10%的场景。当实际波动超过这一范围时,模型需要调用额外的算力进行实时推理,而系统的算力分配是固定的——70%用于常规处理,20%用于应急响应,10%作为冗余。当水质波动触发应急响应机制后,若冗余算力被完全占用,系统会通过报错「没有更多数据了」来强制中断数据输入,防止模型因算力不足而输出错误指令。
这一案例的赛制逻辑在于:废水处理系统的稳定性并非由数据量单一维度决定,而是由数据质量、算力分配、模型鲁棒性三者的动态平衡共同支撑。很多人以为增加数据量就能提升系统稳定性,其实不然——在算力有限的情况下,盲目增加数据量只会加速系统崩溃。该园区最终通过优化算力分配策略(将冗余算力从10%提升至15%)和扩展模型训练数据集(增加±20%波动场景的训练样本),成功解决了这一问题。
数据阈值的设定,本质上是系统对自身能力的清醒认知。当系统报错「没有更多数据了」时,真正的危机并非数据缺失,而是系统已达到其处理能力的边界。这一边界的突破,需要从算力扩容、模型优化、数据预处理等多维度协同推进,而非简单归因于数据采集端的故障。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

