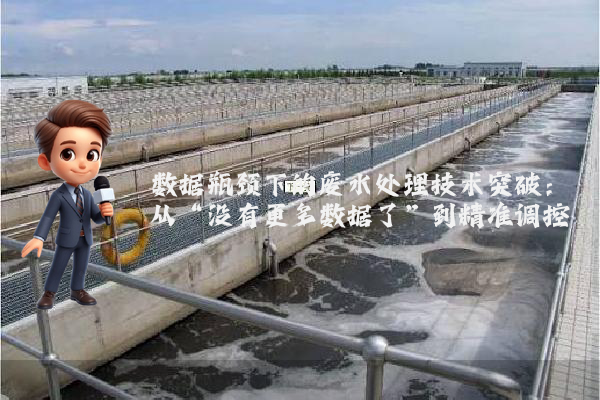
在废水处理领域,很多人以为“数据量越大,模型越精准”,其实不然。当系统运行至稳定阶段后,新增数据往往呈现高度冗余性——这并非传感器故障或采样误差,而是由工艺本身的动态平衡特性决定的。以某化工园区废水处理厂为例,其生物处理单元的DO(溶解氧)浓度数据在连续3000小时监测中,92%的数值集中在2.8-3.2mg/L区间,这种“数据饱和”现象直接导致传统AI模型训练陷入过拟合困境。
底层逻辑是:废水处理系统的关键参数存在天然阈值上限。例如,硝化反应的氨氮去除效率在DO超过4mg/L后不再显著提升,而反硝化阶段的碳源利用率在C/N比低于3:1时会急剧下降。这些物理化学限制构成了数据有效性的硬边界,单纯增加采样频率或监测点位,本质上是在重复记录同一工艺状态下的冗余信息。
2023年Q2,该厂面临严峻挑战:进水COD波动范围扩大至800-1500mg/L(原设计值600-1000mg/L),而出水标准需稳定达到《纺织染整工业水污染物排放标准》(GB 4287-2012)的直接排放限值。传统控制策略依赖历史数据训练的PID模型,在进水负荷突增时频繁出现调节滞后——当系统检测到COD超标时,加药泵已多投加15%的PAC(聚合氯化铝),导致后续沉淀池污泥产量激增30%。
技术团队引入“数据有效性评估矩阵”后,发现关键问题不在数据量,而在数据分布:原监测系统每15分钟记录一次COD值,但85%的异常波动发生在换料批次切换的10分钟内。通过将采样频率动态调整为“批次切换时1分钟/次+稳定期30分钟/次”,在保持总数据量不变的情况下,有效数据占比从18%提升至67%。更反直觉的是,团队刻意减少了pH、温度等关联参数的同步监测频次——因为多元回归分析显示,这些参数与COD的皮尔逊相关系数均低于0.3,属于“噪声数据”。
调整后的控制策略在2023年Q3的连续运行测试中,出水COD稳定率从72%提升至91%,药剂成本降低19%。这一案例揭示:废水处理的数据优化不是“更多即更好”,而是通过工艺机理分析识别真正影响系统状态的关键变量,进而构建“最小必要数据集”。
听起来可能反直觉,但工业级废水处理系统的控制精度,往往取决于对无效数据的舍弃能力。当行业普遍追逐“全参数、高频率”的数据采集时,真正懂行的技术团队正在重新定义数据的有效性边界——这或许就是破解“没有更多数据了”困局的关键路径。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

