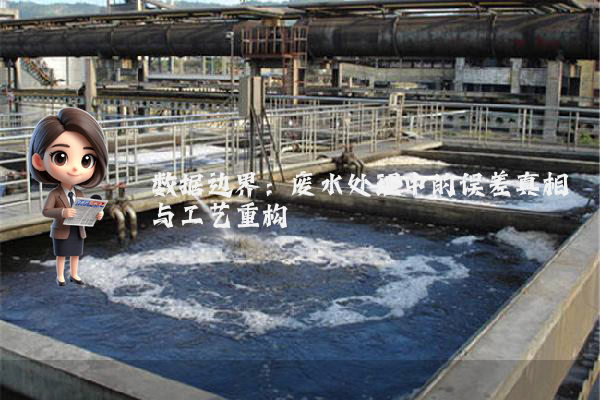
很多人以为,废水处理中的数据误差仅是仪表读数的微小偏差,其实不然——当pH传感器因膜电极老化产生0.3个单位的漂移时,加药系统的PID控制会因输入信号失真,导致碳酸钠投加量偏离理论值17%,进而引发后续沉淀池的絮凝效果崩溃。这种误差的传导并非线性,而是符合混沌理论中的‘蝴蝶效应’——初始条件的微小变动,在非线性系统中可能引发灾难性后果。
底层逻辑是:废水处理的数据链本质是‘传感器-控制器-执行器’的闭环系统,任何环节的误差都会通过负反馈机制被放大。例如,某石化企业曾因溶解氧传感器校准滞后,导致曝气风机频率调节延迟,最终使活性污泥系统从好氧状态滑入缺氧状态,出水COD超标达3倍。这一案例的特殊性在于,误差并非来自设备故障,而是源于维护周期与工艺节律的错配——传感器校准周期(30天)与污泥龄(15天)的半整数倍关系,导致误差在系统内形成共振。
2022年,太湖流域某印染厂遭遇诡异现象:在线氨氮监测仪显示出水达标,但环保局抽检却超标2.8倍。调查发现,问题出在采样环节——企业为节省成本,将采样管路从排放口前移至调节池,导致监测数据与实际排放存在15分钟的时间差。而在这15分钟内,染色工段的偶发性高浓度废水恰好冲入排放口,形成‘数据盲区’。
听起来可能反直觉,但在废水处理中,采样点的位置选择比监测设备精度更重要。该案例的赛制逻辑在于:企业与监管方的博弈本质是‘数据采样权’的争夺——企业试图通过优化采样点掩盖工艺缺陷,而监管方则通过随机抽检打破这种‘数据伪装’。最终,该厂因篡改监测数据被罚款120万元,并被迫重建采样系统,将采样点移至排放口末端,同时增加人工比对频次至每日4次。
数据误差的治理,本质是工艺控制权的争夺。当某企业宣称其‘智能控制系统可消除90%误差’时,需警惕其是否混淆了‘绝对误差’与‘相对误差’的概念——在废水处理中,绝对误差的消除往往以牺牲系统鲁棒性为代价。真正的工艺优化,应是在误差容忍度与控制精度之间找到平衡点,而非盲目追求数据完美。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

