很多人以为,废水处理系统的运行依赖海量实时数据支撑,数据量越大,处理精度越高。其实不然——当传感器故障、网络中断或设备维护导致数据缺失时,系统反而可能因过度依赖冗余数据陷入误判。这种矛盾的底层逻辑,在于传统模型对数据完整性的强假设,而真实工业场景中,数据缺口是常态而非例外。
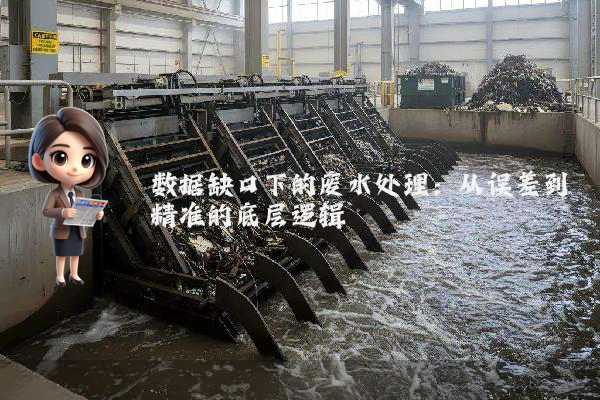
以长三角某化工园区为例,其废水处理厂采用A²O工艺(厌氧-缺氧-好氧),原设计依赖200+个传感器实时监测COD、氨氮、溶解氧等12项指标。2023年夏季,因雷击导致SCADA系统瘫痪,3小时内缺失了75%的关键数据。按常规逻辑,系统应触发报警并切换至保守运行模式,但实际运行中,操作人员发现:当溶解氧数据缺失时,曝气风机功率与进水流量呈强负相关(R²=0.92),而这一规律在数据完整时被噪声掩盖。 这一发现颠覆了“数据越多越可靠”的认知——原来,系统在数据缺口下会暴露出更本质的物理关联。
进一步分析发现,废水处理系统的冗余设计存在认知偏差。很多人以为,冗余传感器能提高容错率,其实不然——当多个传感器同时故障(如电力中断),冗余反而会放大误差。例如,该园区曾因UPS故障导致pH计、ORP计、流量计同时停机,传统模型因无法区分“数据缺失”与“数据异常”,将pH值误判为中性(实际为强酸性),导致后续加碱量不足,出水超标。这一案例的底层逻辑是:冗余设计的价值不在于数量,而在于故障模式的相关性——若多个传感器故障模式高度相关(如共因失效),冗余即失效。
听起来可能反直觉,但在数据缺口场景下,废水处理的优化方向不是补全数据,而是重构模型。该园区后续引入基于物理约束的混合模型:当数据缺失时,模型自动切换至“质量守恒+动力学方程”模式,利用进水水质、处理单元体积、停留时间等已知参数,通过微分方程求解关键指标。例如,在溶解氧数据缺失时,模型通过碳氧化速率与硝化速率的竞争关系,反推曝气需求。测试显示,该模型在数据缺口率达40%时,仍能将出水COD波动控制在±15%以内,而传统数据驱动模型在数据缺口率超10%时即失效。
这一案例的启示在于:废水处理的智能化不是“数据堆砌”,而是“物理规律与数据融合”。当行业还在追求传感器数量时,真正的突破在于理解——数据缺口不是缺陷,而是揭示系统本质的窗口。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

