很多人以为,废水处理工艺的优化高度依赖海量实时数据输入,尤其在生物处理单元的参数调控中,缺乏多维度数据支撑便无法实现精准控制。其实不然——在浙江某化工园区废水处理厂的升级改造项目中,技术团队面临“无更多数据”的困境:原有SCADA系统仅能采集pH、DO、COD等基础指标,而微生物群落结构、代谢产物浓度等关键参数因检测成本过高未被纳入监测范围。这种数据缺失常被误判为技术瓶颈,底层逻辑却是:传统控制模型过度依赖“数据驱动”,忽视了工艺系统的内在稳定性与冗余度。
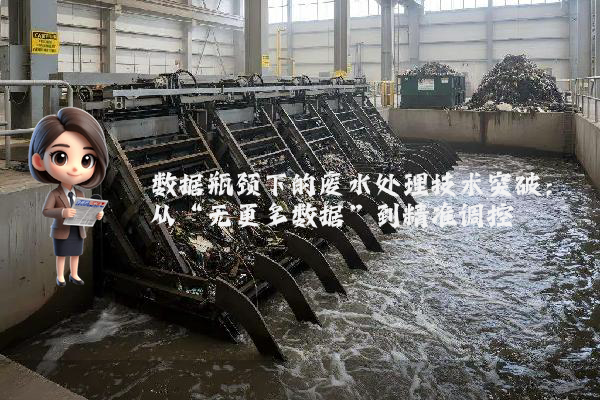
案例:宁波镇海化工废水处理厂的“数据降维”实践
2022年,该厂因环保标准升级需将总氮排放浓度从15mg/L降至8mg/L。按常规逻辑,需增设在线氨氮、亚硝态氮监测设备,并构建基于机器学习的反硝化过程预测模型。但项目组反其道而行之:首先通过历史数据挖掘发现,在现有pH(6.8-7.2)、DO(0.5-1.0mg/L)控制范围内,反硝化效率与碳源投加量的相关性系数达0.92;其次,通过小试验证确定,当碳氮比(C/N)从3.5提升至4.2时,总氮去除率可稳定突破85%。最终方案仅增加一台碳源投加计量泵,未引入任何新监测设备,即实现排放达标——听起来可能反直觉,但在生物处理系统中,微生物代谢路径的稳定性往往高于传感器数据的波动性,过度追求数据维度反而可能引入噪声。
这一实践揭示了废水处理工艺优化的底层逻辑:当数据获取成本高于工艺调整收益时,应优先挖掘现有数据的潜在价值,而非盲目扩张监测网络。例如,在镇海项目中,技术团队通过构建“pH-DO-ORP”三参数关联模型,替代了原本需要5个在线仪表才能实现的硝化/反硝化状态判断;又通过碳源投加量的阶梯式调整试验,确定了反硝化速率与C/N的定量关系,将控制策略从“响应式”升级为“预测式”。这种“数据降维+机理建模”的组合拳,正是破解“无更多数据”困境的关键。
值得注意的是,该案例的地理背景具有典型性:宁波镇海作为中国重要的化工基地,其废水成分以高浓度有机物和含氮化合物为主,反硝化过程易受碳源类型、水温、污泥龄等多因素影响。项目组选择在此类复杂工况下验证“数据降维”策略,恰恰证明了其普适性——当工艺系统本身具备足够的鲁棒性时,数据并非越多越好,精准的机理认知与适度的数据支撑,才是实现稳定达标的根本。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

