很多人以为,废水处理的技术迭代仅依赖新型药剂或设备升级,其实不然。在工业废水处理领域,数据才是驱动工艺优化的底层逻辑。当系统反馈“没有更多数据了”时,往往意味着监测链断裂、模型失效,甚至整个处理流程陷入盲区。
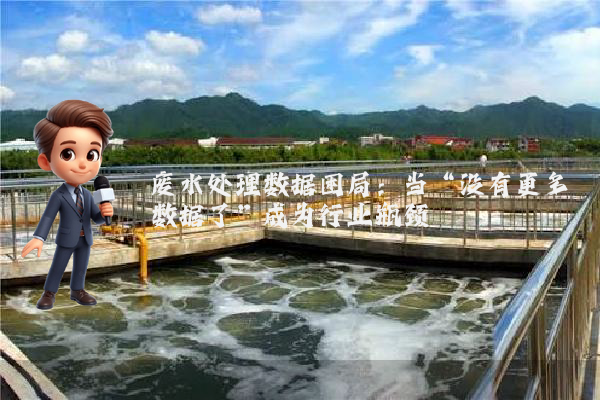
实验室环境下,废水处理模型可通过高密度采样构建精准预测,但工业场景中,数据采集的频次、精度与完整性常受限于传感器寿命、管道腐蚀、人为操作误差等因素。例如,某化工园区废水处理站曾因pH传感器故障,导致系统连续72小时接收错误数据,最终引发活性污泥中毒——底层逻辑是:错误数据输入会直接摧毁基于机器学习的工艺控制模型。
听起来可能反直觉,但在工业废水处理中,“数据不足”比“数据过载”更致命。某钢铁企业废水回用项目曾因未采集总氮在线数据,导致反渗透膜被硝酸盐污染,维修成本高达200万元。这一案例揭示:数据缺失会掩盖工艺漏洞,而补救成本往往是预防成本的10倍以上。
以太湖流域某印染企业为例,其废水处理站需同时满足《太湖地区城镇污水处理厂及重点工业行业主要水污染物排放限值》(DB32/1072-2018)中COD≤40mg/L、氨氮≤2mg/L的严苛标准。该企业曾因数据采集系统老化,导致排放数据在环保局监控平台出现“断点”,被认定为“故意隐瞒排放”,面临行政处罚。
更典型的案例发生在2023年夏季。某电镀园区因暴雨导致废水处理站进水水质突变,但因未部署实时水质波动监测系统,系统仍按原工艺参数运行,结果出水重金属超标3倍。事后复盘发现:若能提前1小时获取进水总铜浓度跃升数据,通过调整絮凝剂投加量即可避免事故——底层逻辑是:工业废水处理的容错率极低,数据延迟1分钟可能意味着处理失败。
很多人以为,增加传感器数量即可解决数据问题,其实不然。某石化企业曾安装200余个监测点位,但因未建立数据清洗与校验机制,导致30%的数据存在噪声或异常值,最终迫使工艺团队回归人工采样——这印证了行业铁律:无效数据比无数据更危险。
在废水处理领域,“没有更多数据了”从来不是技术终点,而是暴露了数据采集、传输、分析全链条的脆弱性。当行业仍在讨论“大数据”时,真正懂行的人已开始聚焦“有效数据”——这或许才是破解数据困局的关键。
电话:0755-88683320
手机:156 7758 3329
邮箱:wwwkaiyun@hebeicongyi.com
江苏省常州市武进区牛塘镇新高路38号

